Anthropic lance Claude Fable 5.2 et Claude Mythos 5.2 le 9 novembre 2026. Cette mise à jour apporte des progrès en programmation et en raisonnement, une génération plus rapide, des tarifs API réduits de 20 % et environ 55 % de blocages en moins par rapport à Fable 5.1, selon les premiers tests d'Anthropic.
Au-delà des performances annoncées, cette version pose une question pratique : dans quels cas son utilisation se justifie-t-elle ? La comparaison avec GPT-6 Astra, le coût des tâches et les conditions d'accès selon l'abonnement Claude permettent d'y voir plus clair.
En bref : les nouveautés de Claude Fable 5.2
Fable 5.2 vise les tâches complexes et les projets longs. L'API passe à 8 dollars par million de tokens en entrée et 40 dollars en sortie, contre 10 et 50 dollars pour Fable 5.1 et GPT-6 Astra. Les filtres de sécurité produisent moins de blocages, tandis que l'accès dans Claude dépend toujours de l'abonnement. Opus 5.5 reste le point de départ recommandé par Anthropic pour la plupart des usages.
Ce qui change entre Claude Fable 5.1 et Fable 5.2
Selon l'annonce d'Anthropic, Fable 5.2 génère ses réponses jusqu'à 30 % plus vite que Fable 5.1. Cela concerne la vitesse de génération, pas une réduction garantie de 30 % de la durée totale d'une tâche.
Anthropic destine notamment ce modèle aux recherches en plusieurs étapes, aux longues sessions de développement et aux analyses qui aboutissent à un document, un tableau ou une présentation. L'objectif est de lui confier une mission avec un résultat attendu, puis de le laisser avancer avec les outils disponibles.
Sa fiche technique indique une fenêtre de contexte d'un million de tokens et une sortie maximale de 128 000 tokens. Ces unités correspondent aux fragments de texte traités par le modèle. La fenêtre de contexte représente la quantité d'informations qu'il peut prendre en compte dans une requête ; elle ne garantit pas qu'il exploite parfaitement chaque détail.
Anthropic rapporte notamment la création d'un prototype de système d'exploitation démarrant sur un ordinateur portable, après huit jours de travail et la coordination de plus de 1 000 sous-agents. Cette démonstration mobilise des moyens considérables ; elle ne préjuge pas du résultat d'une session ordinaire.
À une échelle plus quotidienne, cette logique d'action se retrouve dans mon article sur l'utilisation de Claude Code pour accélérer une TV Android. Ce type d'usage donne une idée de l'intérêt pratique des assistants capables d'intervenir sur un problème technique, sans nécessiter systématiquement le modèle le plus puissant.
La comparaison avec GPT-6 Astra, présenté lors de son lancement, permet de situer les progrès de Fable 5.2. Les résultats ci-dessous sont publiés par Anthropic. Ils donnent des repères, mais ne remplacent pas une comparaison sur les tâches réellement confiées à ces assistants.
Les scores utilisent le niveau d'effort maximal disponible, sauf FrontierCode où les résultats de Fable sont obtenus au niveau xhigh. OSWorld porte sur un sous-ensemble hors ligne. Les conditions d'évaluation sont détaillées dans la publication d'Anthropic.
Fable 5.2 progresse nettement face à Fable 5.1 et devance Astra sur les évaluations retenues ici. Cela ne signifie pas qu'il sera meilleur sur chaque demande. La qualité de rédaction, le respect des consignes et le nombre de corrections nécessaires comptent aussi dans un usage quotidien.
Prix de l'API Claude Fable 5.2 et comparaison avec Astra
La baisse de prix concerne les informations envoyées au modèle comme les réponses qu'il génère. Voici les tarifs API de base, en dollars américains par million de tokens, en traitement standard, hors cache et frais d'outils. Pour Astra, ces tarifs concernent les requêtes contenant jusqu'à 272 000 tokens en entrée.
Les tarifs publiés par Anthropic et OpenAI montrent que Fable 5.2 coûte 20 % moins cher par token qu'Astra en entrée et en sortie. Cette comparaison concerne l'API ; elle ne décrit ni le prix ni les quotas des abonnements Claude et ChatGPT.
Un tarif inférieur ne garantit toutefois pas une facture finale plus basse. Les modèles peuvent consommer des quantités différentes de tokens, notamment pour raisonner, reprendre une tâche ou coordonner plusieurs sous-agents. Le cache et les outils utilisés modifient également le coût.
Le graphique FrontierCode publié par Anthropic illustre cette différence. Au niveau d'effort high, Fable 5.2 atteint 45,3 %, contre 42,8 % pour Astra, à un coût par tâche annoncé comme comparable. Passer à xhigh porte Fable à 49,1 %, mais augmente nettement la dépense.
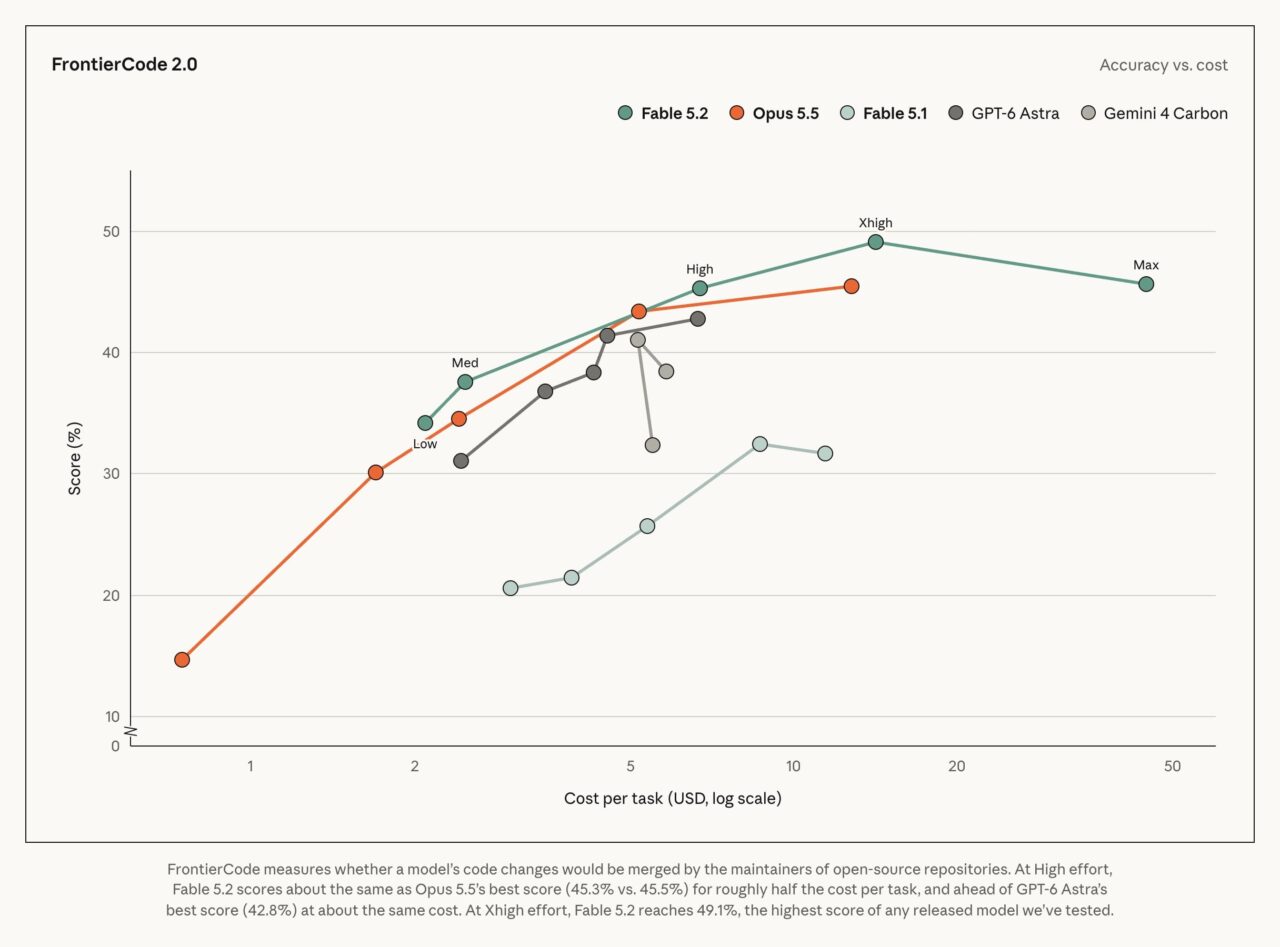
Sur FrontierCode 2.0, Fable 5.2 dépasse GPT-6 Astra à coût comparable en mode High. Son meilleur score, atteint en Xhigh, demande un budget plus élevé. Source : Anthropic.
C'est ce compromis qui m'intéresse : combien faut-il dépenser pour obtenir un résultat suffisamment bon ? Quelques points supplémentaires peuvent justifier le surcoût sur un problème difficile. Pour une tâche courante déjà bien résolue, l'intérêt est moins évident.
Fable 5.2 propose aussi un mode rapide optionnel, avec des tarifs API doublés : 16 dollars en entrée et 80 dollars en sortie par million de tokens. Son intérêt dépend du temps gagné sur la tâche réelle.
Fable 5.2 : environ 55 % de blocages en moins
La réduction des blocages est une autre nouveauté importante. Anthropic annonce environ 55 % de blocages en moins par rapport à Fable 5.1, d'après ses premiers tests sur Claude.ai, Claude Code et Cowork. La diminution atteint environ 60 % en cybersécurité et 40 % en biologie.
L'entreprise explique avoir réduit les faux positifs de ses filtres de sécurité. L'objectif est de limiter les demandes légitimes bloquées à tort. Les garde-fous restent actifs : ces résultats préliminaires ne signifient pas que tous les types de refus diminuent de 55 % pour chaque utilisateur.
Anthropic annonce également Mythos 5.2. Les deux versions reposent sur le même modèle, mais Fable conserve des garde-fous renforcés en cybersécurité et en biologie. L'accès à Mythos passe par des programmes de vérification destinés aux organisations concernées.
Fable 5.2 est disponible dans les offres payantes de Claude, avec des conditions différentes selon l'abonnement. Sur Max et Ultra, les modèles Fable peuvent utiliser jusqu'à 50 % du quota hebdomadaire inclus. Ils consomment ce quota plus rapidement que les autres modèles. Sur Pro et les sièges standard Team, leur utilisation repose normalement sur des crédits payants supplémentaires.
Une offre de lancement permet toutefois aux abonnés Pro et aux sièges standard Team d'utiliser Fable dans la limite de 50 % de leur quota hebdomadaire, sans supplément, du 9 novembre au 17 novembre 2026 à 8 h 59, heure de Paris. Après cette période, l'utilisation revient aux crédits payants. Il s'agit d'une part du quota existant, pas d'un accès illimité.
Dans Claude, le modèle se choisit depuis le sélecteur. Il n'est pas disponible avec l'offre gratuite. Les développeurs peuvent aussi utiliser l'identifiant claude-fable-5-2 dans l'API.
Les limites à garder en tête avant de choisir Fable 5.2
Une meilleure performance dans un classement ne suffit pas à valider un travail. Il reste nécessaire de définir ce que signifie une tâche terminée et de vérifier le résultat. Pour du développement, cela implique des tests ; pour une recherche, des sources contrôlables. Une réponse convaincante ne suffit pas.
Pour comparer Fable et Astra, le plus utile reste de leur confier une même mission, avec les mêmes documents et les mêmes critères de réussite. Le coût de la session doit alors être mis en regard du résultat obtenu et du temps passé à le corriger.
Anthropic recommande Opus 5.5
Dans cette annonce, il y a quelque chose d'intéressant : Anthropic recommande de commencer avec Opus 5.5 pour la plupart des travaux, puis de monter vers Fable si les résultats restent insuffisants même avec un effort de raisonnement élevé.
Le critère intéressant est le travail réellement économisé : moins de corrections, moins d'allers-retours et un résultat plus facile à vérifier. Si Fable 5.2 apporte cela sur une mission précise, son intérêt dépasse largement une ligne supplémentaire dans un classement. C'est sur ce terrain que cette mise à jour doit faire ses preuves.