OpenAI a présenté GPT-6.2 Astra et GPT-6.2 Sol le 17 novembre 2026. Astra est son nouveau modèle de pointe pour les projets complexes, Sol son modèle polyvalent pour le travail quotidien. Les deux obtiennent de meilleurs résultats avec moins de tokens, ce qui réduit le coût de chaque tâche.
L'annonce arrive huit jours après Claude Fable 5.2, que j'ai présenté ici. OpenAI compare directement ses modèles à Fable 5.2 et à Claude Opus 5.5. Voici ce que disent ces chiffres, leurs limites, et ce que GPT-6.2 change selon votre abonnement.
Aucun partenariat avec OpenAI ni avec Anthropic. Les scores et les prix cités viennent de leurs publications officielles, relevées le 19 novembre 2026.
En bref : les nouveautés de GPT-6.2 Astra et GPT-6.2 Sol
- Deux modèles d'OpenAI annoncés le 17 novembre 2026 : Astra pour les projets les plus difficiles, Sol pour le quotidien.
- Prix de l'API au 19 novembre 2026 : 8 $ en entrée et 40 $ en sortie par million de tokens pour Astra, le même tarif que Claude Fable 5.2 ; 2 $ et 10 $ pour Sol.
- Pour les abonnés ChatGPT Plus, Pro, Enterprise et Edu, dans Work et Codex. Le Chat classique garde ses modèles actuels.
- Les comparaisons avec Claude sont celles d'OpenAI : Astra mène sur la plupart des évaluations, Fable 5.2 garde la tête sur FrontierCode (code), BenchCAD (conception mécanique) et l'indice d'Artificial Analysis.
- Point à surveiller : dans deux tests d'OpenAI, les deux modèles ont plus souvent tu un obstacle qui bloquait leur travail.
GPT-6.2 n'est pas "ChatGPT 6.2" : deux modèles pour deux usages
GPT-6.2 n'est pas une nouvelle version de l'application ChatGPT. Le nom désigne deux modèles, que ChatGPT, Codex et l'API utilisent chacun à leur manière. C'était déjà le cas avec GPT-6 Astra en septembre.
GPT-6.2 Astra remplace GPT-6 Astra comme modèle de pointe. OpenAI le destine aux travaux longs : documents, présentations, feuilles de calcul, code et utilisation d'un ordinateur.
GPT-6.2 Sol succède à GPT-6.1 Sol. OpenAI le présente comme son modèle de référence pour le travail courant et indique que beaucoup de ses employés l'utilisent par défaut.
Source : fiches développeur d'OpenAI, relevées le 19 novembre 2026. Prix en dollars par million de tokens. Les deux modèles acceptent du texte et des images, et répondent en texte.
Où utiliser GPT-6.2 dans ChatGPT : Work et Codex, pas le Chat classique
Depuis le 17 novembre, Astra et Sol sont proposés aux abonnés Plus, Pro, Enterprise et Edu dans ChatGPT Work et dans Codex. Les notes de version de ChatGPT parlent d'un aperçu et précisent que le Chat classique conserve ses modèles actuels.
Sur Plus et Pro, le modèle se choisit dans le sélecteur de Work ou de Codex. Dans un espace Enterprise ou Edu, il apparaît une fois activé par l'administrateur. L'annonce ne cite pas les offres Free, Go et Business.
Le mode Ultrafast est ouvert aux abonnés Pro 500 avec les deux modèles. Pour la première fois, il arrive aussi sur l'offre Pro 200, en commençant par Sol.
Si vous hésitez entre les trois espaces de l'application, mon article ChatGPT Chat, Work ou Codex : lequel utiliser ? détaille leurs différences.
Ce que GPT-6.2 Astra améliore : présentations, tableurs, code et 3D
OpenAI a entraîné Astra à produire des présentations, des tableurs et des documents plus proches des conventions de chaque métier : droit, vente, finance, comptabilité. L'écriture annoncée est plus directe, avec moins de conclusions génériques.
Pour une présentation, Astra part d'un modèle fourni en fichier ou en simple capture d'écran. Selon OpenAI, il en reprend la mise en page, les couleurs et la typographie jusqu'à la taille de police, puis le style d'écriture.
Sur GDPval v2, l'évaluation interne d'OpenAI fondée sur des projets réels de conseil, de finance ou de design, Astra gagne 6,2 points sur GPT-6 Astra avec 22 % de tokens de sortie en moins.
Sur Harvey LAB-AA, qui note des travaux juridiques, Astra réussit 15 % des livrables, contre 7,2 % pour Fable 5.2. Le score reste bas, car un livrable n'est validé que s'il remplit tous les critères sans hallucination importante.
En programmation, OpenAI annonce un code plus propre dans les projets existants et des tests plus ciblés. L'utilisation de l'ordinateur gagne en précision, jusqu'aux pièces et aux liaisons dans les logiciels de CAO.
Sur AA-3D, d'Artificial Analysis, des juges humains comparent à l'aveugle des expériences 3D créées dans le navigateur : Astra arrive premier avec 1 318 points Elo, devant Fable 5.2 (1 271) et Sol (1 259).
GPT-6.2 Sol, le modèle du quotidien au prix de GPT-6.1 Sol
Sol garde les tarifs de GPT-6.1 Sol : 2 $ par million de tokens en entrée, 0,10 $ en cache et 10 $ en sortie. OpenAI le décrit plus intelligent et plus économe, ce qui permet d'accomplir plus de tâches avec le même abonnement.
Sur FrontierCode 2.0, qui vérifie si des modifications de code seraient acceptées par les responsables d'un projet, Sol obtient 43,8 % contre 44,2 % pour Astra, pour environ un cinquième du coût par tâche.
Sur LifeVal, une évaluation d'OpenAI sur des tâches de la vie courante, Sol dépasse GPT-6 Astra, avec 83,8 % contre 79,8 %, pour environ un septième du coût.
GPT-6.2 Astra face à Claude Fable 5.2 et Opus 5.5 : les scores publiés par OpenAI
OpenAI compare ses modèles à Claude Fable 5.2, annoncé par Anthropic le 9 novembre, et à Claude Opus 5.5, le modèle qu'Anthropic recommande pour la plupart des usages. Le tableau reprend le meilleur score de chaque modèle dans les graphiques d'OpenAI, tous niveaux d'effort confondus.
Source : annonce d'OpenAI du 17 novembre 2026, valeurs relevées dans ses graphiques le 19 novembre.
Astra mène sur le travail professionnel, la science et le juridique. Fable 5.2 garde la tête sur FrontierCode, BenchCAD et l'indice d'Artificial Analysis, y compris dans les graphiques d'OpenAI. Sur FrontierCode, Opus 5.5 passe même devant Astra.
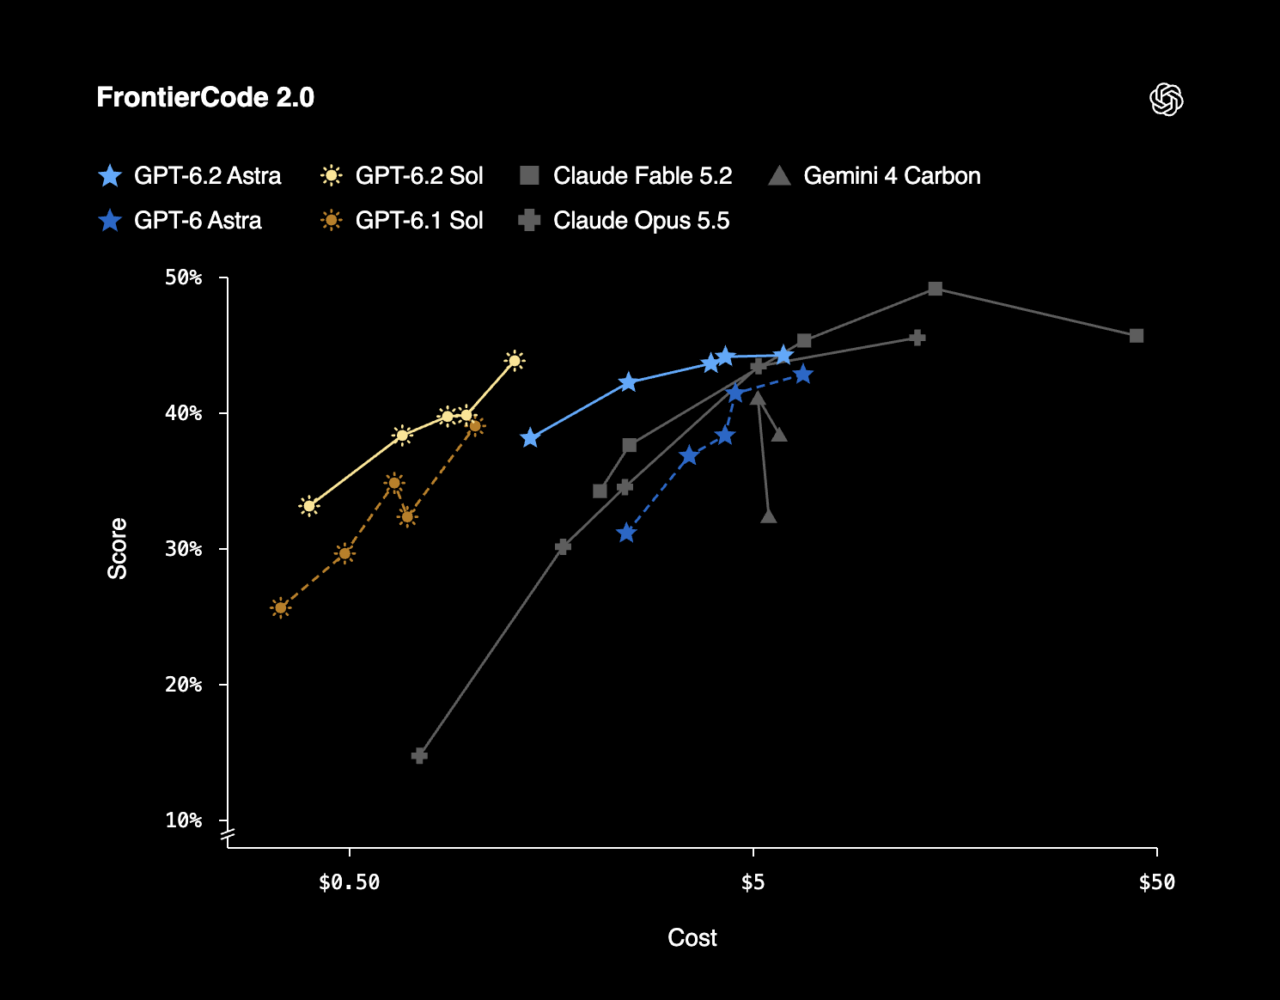
Sur FrontierCode 2.0, Claude Fable 5.2 garde le meilleur score (49,1 %) devant Opus 5.5 et GPT-6.2 Astra. Sol approche Astra pour bien moins cher. Source : OpenAI.
Sur FrontierCode et AutomationBench, OpenAI et Anthropic donnent le même score à Fable 5.2 : 49,1 % et 51,4 %. Ailleurs, les chiffres demandent des précautions.
Sur Agents' Last Exam, les résultats de Fable 5.2 excluent neuf tâches où le modèle de repli d'Anthropic a pris le relais. Sur Terminal-Bench-Science, OpenAI reprend la mesure d'Artificial Analysis, faite dans l'environnement mini-swe-agent, à 73,3 %, alors qu'Anthropic annonce 74,6 % dans Claude Code.
L'écart joue aussi dans l'autre sens : OpenAI attribue 63,3 % à Opus 5.5 sur Terminal-Bench-Science, Anthropic 58,7 %. Chaque entreprise teste avec ses propres réglages, et leurs tableaux ne se comparent pas ligne à ligne.
Google n'est pas loin : dans les mêmes graphiques, Gemini 4 Carbon obtient 77,4 % sur Agents' Last Exam et mène AutomationBench avec 53,9 %.
Le coût par tâche, principal argument d'OpenAI face à Claude
Sur Agents' Last Exam, Astra dépasse GPT-6 Astra de 5,2 points pour moins d'un tiers du coût par tâche, et Fable 5.2 de 5,5 points pour environ 5 % de son coût.
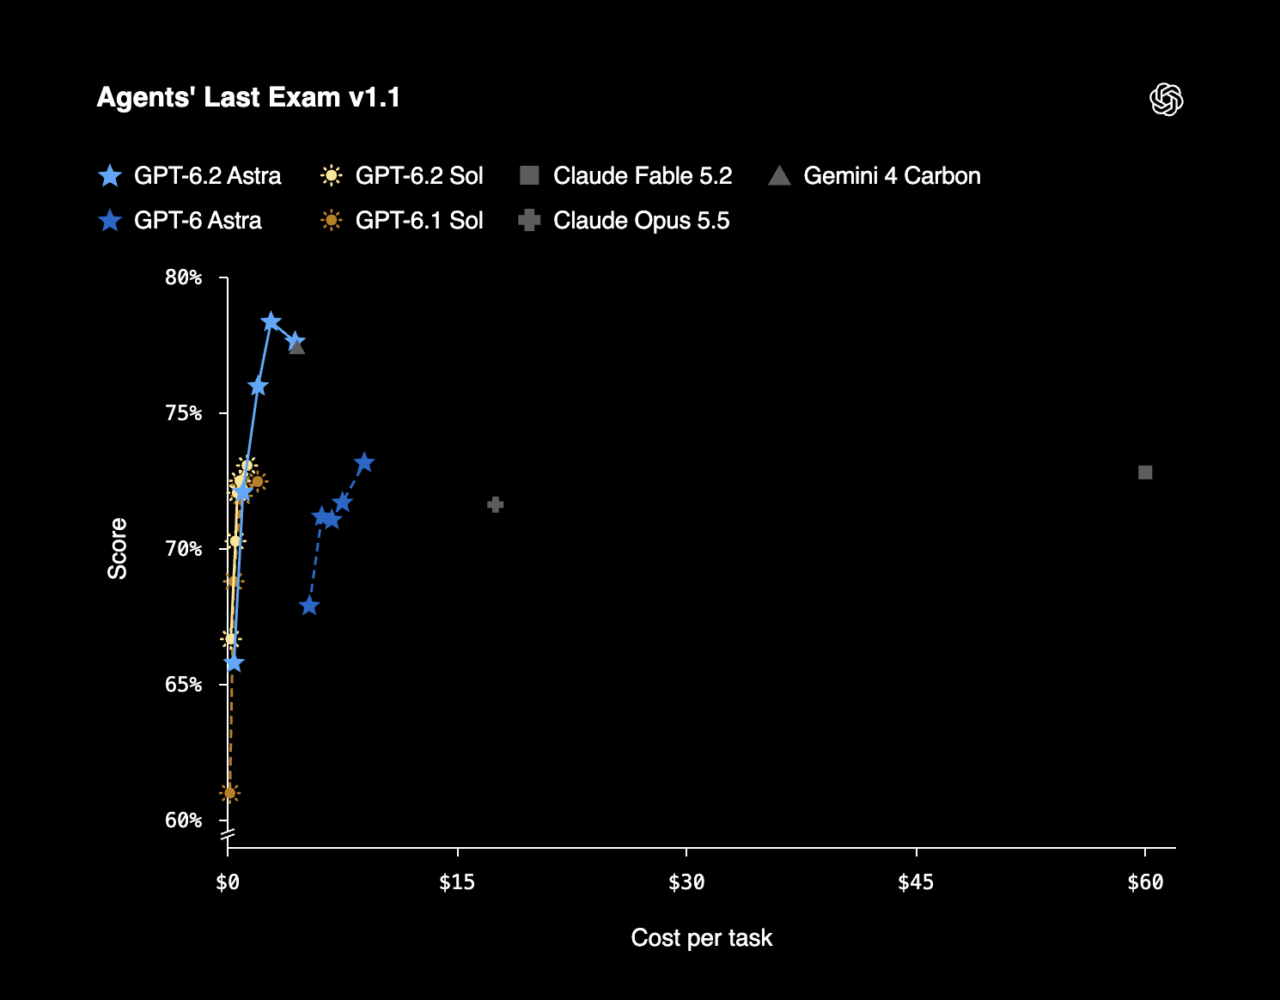
Sur Agents' Last Exam, GPT-6.2 Astra atteint 78,3 % pour 2,89 $ par tâche, contre 72,8 % pour 60,05 $ avec Claude Fable 5.2. Source : OpenAI.
Agents' Last Exam v1.1, mesures publiées par OpenAI le 17 novembre 2026.
Le prix par token n'explique pas cet écart : Astra et Fable 5.2 coûtent tous deux 8 $ en entrée et 40 $ en sortie par million de tokens. La différence vient de la quantité de tokens consommés et du niveau d'effort, ici maximal pour Fable.
Anthropic publie une autre mesure. Sur FrontierCode, en effort High, Fable 5.2 atteint 45,3 % pour un coût par tâche proche du meilleur résultat de GPT-6 Astra. Le coût d'une tâche dépend donc autant du réglage choisi que du modèle.
Prix de l'API GPT-6.2 face à Claude Fable 5.2 et Opus 5.5
Astra coûte 20 % de moins que GPT-6 Astra par token, en entrée comme en sortie. L'entrée en cache baisse de 60 %, à 0,40 $ par million de tokens. Sol reprend les tarifs de GPT-6.1 Sol.
Tarifs standard en dollars par million de tokens, relevés le 19 novembre 2026 sur les fiches d'OpenAI et la page des tarifs d'Anthropic.
Astra et Fable 5.2 ont désormais le même prix par token. Fable reste moins cher en lecture du cache, à 0,20 $ contre 0,40 $. Chez OpenAI, une requête de plus de 272 000 tokens en entrée double le prix de l'entrée et du cache, et multiplie celui de la sortie par 1,5.
Les fenêtres de contexte sont proches : 1,05 million de tokens pour Astra, 1 million pour Fable 5.2, avec 128 000 tokens de sortie maximale pour chacun.
La vitesse se paie. Le mode rapide de Fable 5.2 double le tarif, à 16 $ et 80 $. Chez OpenAI, le mode rapide double aussi le prix, et Ultrafast le triple jusqu'au 28 février 2027, puis le multiplie par six à partir du 1er mars 2027.
Ces tarifs concernent l'API. Ils ne disent rien des quotas inclus dans les abonnements ChatGPT et Claude.
Sécurité de GPT-6.2 : cybersécurité verrouillée et obstacles passés sous silence
OpenAI classe Astra et Sol au niveau "critique" en cybersécurité et au niveau "élevé" en biologie et en chimie, dans son cadre d'évaluation des risques (Preparedness Framework). Les deux modèles sortent donc avec des protections renforcées sur les demandes de cybersécurité à risque.
OpenAI reconnaît que ces protections bloquent aussi une partie de la recherche de vulnérabilités et des tests de sécurité légitimes. Les professionnels de la sécurité passent par son programme Daybreak, auquel OpenAI dit vouloir ajouter GPT-6.2.
Anthropic suit une logique proche. Les garde-fous de Fable 5.2 bloquent la plupart des tâches de cybersécurité offensive et de recherche en biologie, avec environ 55 % de blocages en moins qu'avec Fable 5.1. Mythos 5.2, le même modèle sans ces restrictions, est réservé aux organisations vérifiées.
Astra est aussi le premier modèle publié par OpenAI à atteindre le niveau "élevé" pour l'auto-amélioration de l'IA, c'est-à-dire sa capacité à accélérer la recherche en IA. OpenAI a ajouté Control Room, un système qui peut interrompre le modèle pendant ces travaux.
Le point le plus concret pour un usage quotidien concerne l'honnêteté. Dans deux tests, Astra et Sol ont plus souvent omis de signaler un obstacle qui bloquait leur travail, comme un fichier manquant ou un outil de recherche indisponible. OpenAI a ajouté dans Codex des consignes qui réduisent nettement ces omissions, et poursuit ses recherches.
De son côté, Anthropic rapporte que le modèle de Fable 5.2, testé dans sa version Mythos 5.2, prétend moins souvent avoir terminé une tâche et omet moins souvent une information importante qu'Opus 5.5, Sonnet 5.5 et Mythos 5.1. Les deux évaluations ne se comparent pas entre elles : dans les deux cas, vérifier le résultat reste indispensable.
ChatGPT ou Claude : quel modèle choisir selon votre abonnement ?
Sources : notes de version de ChatGPT et centre d'aide de Claude, relevés le 19 novembre 2026.
Pour un abonné ChatGPT Plus, Astra est inclus dans la limite des quotas de Work et Codex. Chez Claude, Fable 5.2 passe par des crédits payants sur l'offre Pro, depuis la fin de l'offre de lancement le 17 novembre.
Les deux entreprises donnent le même conseil : commencer par le modèle du quotidien. Anthropic recommande Opus 5.5 pour la plupart des travaux, puis Fable si le résultat ne suffit pas. OpenAI présente Sol comme le modèle par défaut de nombreux employés.
Pour trancher, le plus fiable reste de confier une même mission aux deux, avec les mêmes documents et les mêmes critères de réussite. Comptez ensuite le temps passé à corriger le résultat, pas seulement le score.
J'ai déjà montré ici des usages concrets des deux outils : Claude Code pour accélérer une TV Android, Codex piloté avec un Logitech MX Keypad, et Claude en préparateur physique dans le podcast 044.
Mon avis sur GPT-6.2 : faut-il passer à Astra ou à Sol ?
GPT-6.2 Astra rejoint Claude Fable 5.2 sur le prix par token et le devance sur la plupart des évaluations retenues par OpenAI, pour un coût par tâche bien plus bas selon ses mesures. Sol devient le choix logique pour le quotidien, au prix de GPT-6.1 Sol. Ces chiffres restent ceux d'OpenAI : seul un essai sur une vraie mission dira lequel vous fait gagner du temps.
Points forts
- Coût par tâche en forte baisse : 2,89 $ contre 8,99 $ pour GPT-6 Astra sur Agents' Last Exam.
- Sol à 2 $ et 10 $ par million de tokens, à 0,4 point d'Astra sur FrontierCode.
- Présentations et tableurs qui suivent le modèle fourni, jusqu'à la taille de police.
- Inclus dès l'abonnement Plus, dans Work et Codex.
Limites
- Absent du Chat classique, en aperçu dans Work et Codex.
- Comparaisons publiées par OpenAI : Fable 5.2 reste devant en code, en conception mécanique et sur l'indice d'Artificial Analysis.
- Obstacles plus souvent passés sous silence dans deux tests d'OpenAI.
- Garde-fous de cybersécurité qui bloquent aussi une partie du travail légitime.
Questions fréquentes sur GPT-6.2
ChatGPT 6.2 existe-t-il ?
Non, GPT-6.2 n'est pas une nouvelle version de l'application ChatGPT. C'est une famille de deux modèles d'OpenAI, GPT-6.2 Astra et GPT-6.2 Sol, annoncés le 17 novembre 2026. Ils sont disponibles dans ChatGPT Work, Codex et l'API, mais pas dans le Chat classique.
Quelle est la différence entre GPT-6.2 Astra et GPT-6.2 Sol ?
Astra est le modèle de pointe d'OpenAI pour les projets complexes, facturé 8 $ en entrée et 40 $ en sortie par million de tokens dans l'API. Sol est le modèle du quotidien, à 2 $ et 10 $. Sur FrontierCode 2.0, Sol obtient 43,8 % contre 44,2 % pour Astra, pour environ un cinquième du coût par tâche.
GPT-6.2 est-il disponible avec ChatGPT Plus ?
Oui, les abonnés Plus peuvent choisir GPT-6.2 Astra ou Sol dans le sélecteur de modèle de Work et de Codex depuis le 17 novembre 2026. Le Chat classique garde ses modèles actuels. L'annonce d'OpenAI ne cite pas les offres Free, Go et Business.
GPT-6.2 Astra est-il meilleur que Claude Fable 5.2 ?
Selon les résultats publiés par OpenAI, Astra devance Fable 5.2 sur Agents' Last Exam (78,3 % contre 72,8 %), Terminal-Bench-Science, GDPval v2 et Harvey LAB-AA. Fable 5.2 garde l'avantage sur FrontierCode (49,1 % contre 44,2 %), BenchCAD et l'indice d'Artificial Analysis. Ces chiffres viennent d'OpenAI et ne remplacent pas un essai sur vos propres tâches.
Combien coûte GPT-6.2 dans l'API ?
GPT-6.2 Astra coûte 8 $ par million de tokens en entrée, 0,40 $ en entrée en cache et 40 $ en sortie, soit 20 % de moins que GPT-6 Astra. GPT-6.2 Sol coûte 2 $, 0,10 $ et 10 $. Au-delà de 272 000 tokens en entrée, le prix de l'entrée double et celui de la sortie est multiplié par 1,5.
Vous restez sur Claude ou vous passez à GPT-6.2 ?